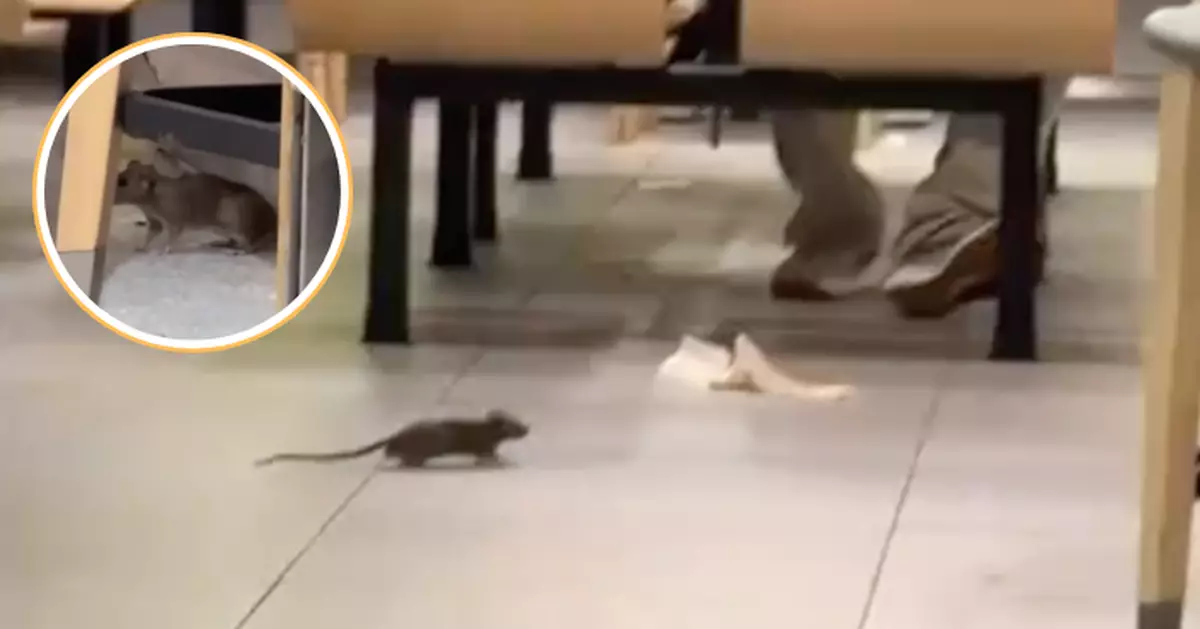
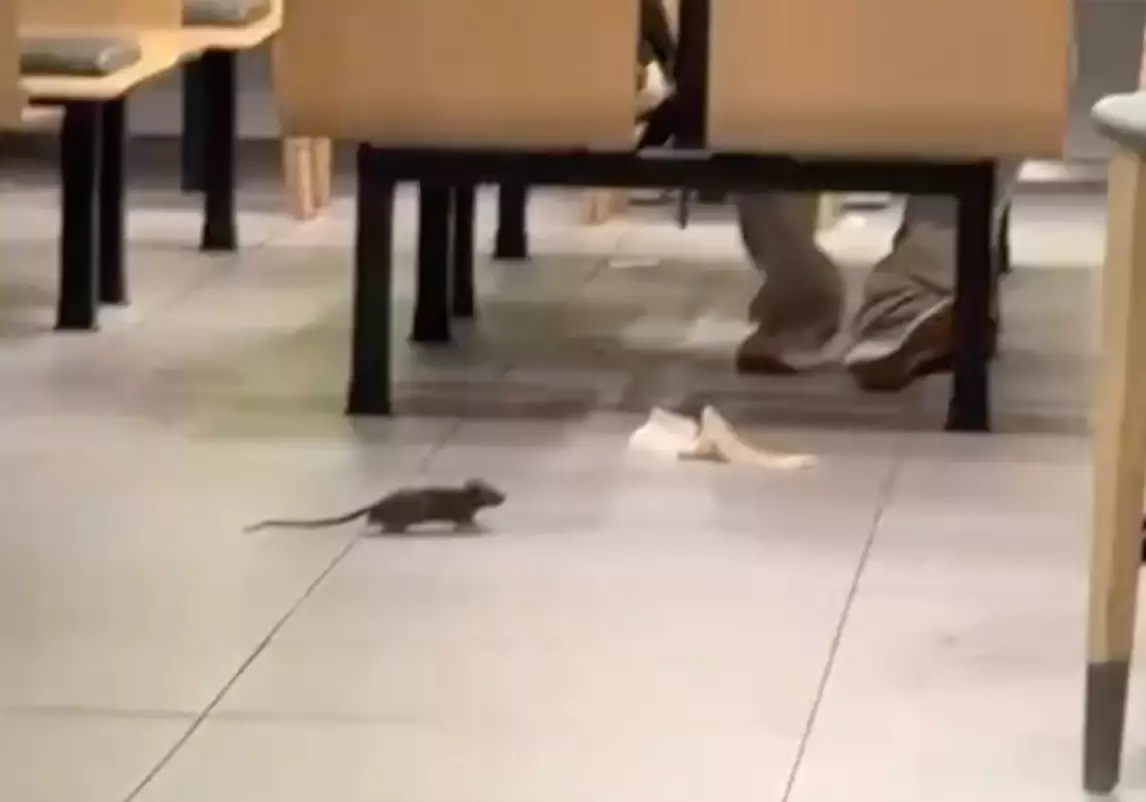
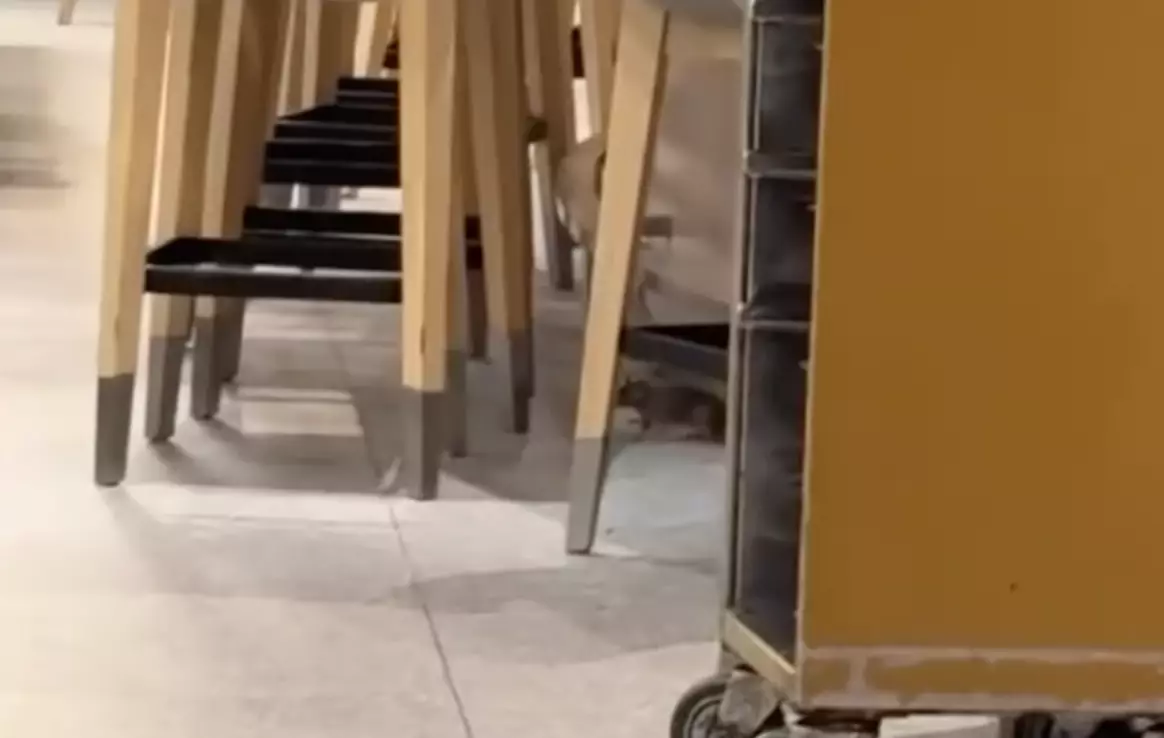
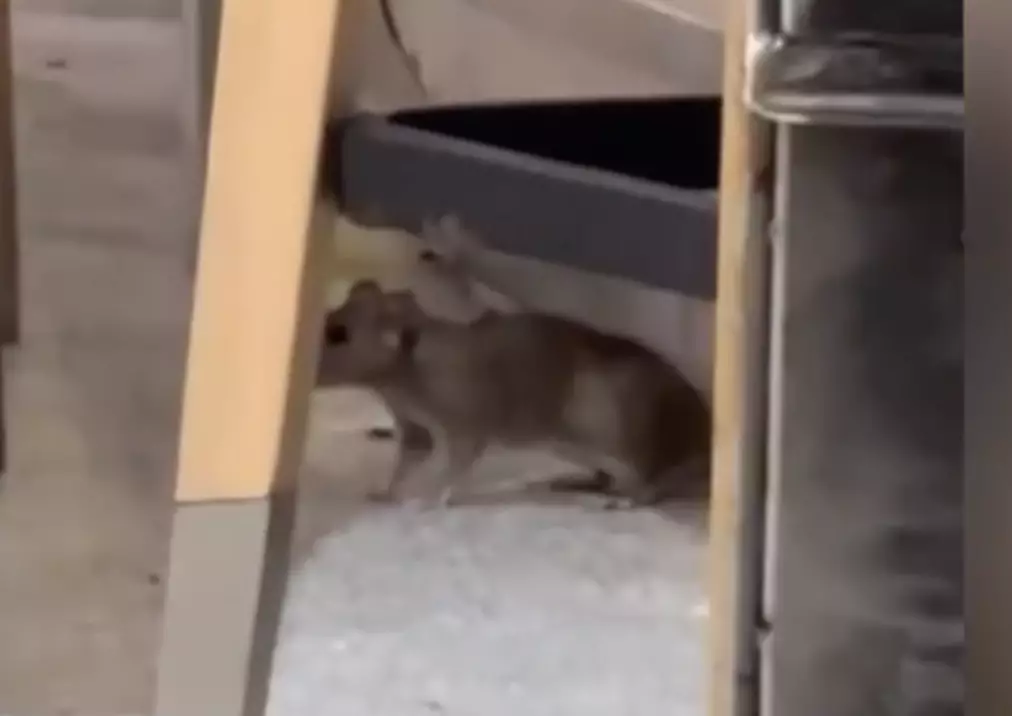
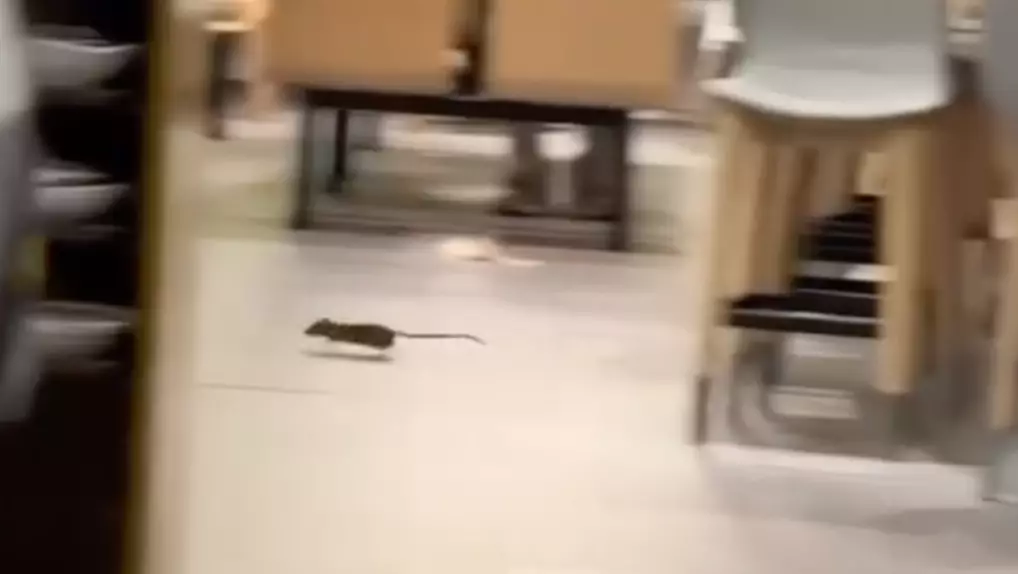
食環署針對九龍灣德福場一間食肆的鼠患投訴展開調查,10月1日派員再度上門巡查,結果發現該食肆衞生狀況未如理想,已按《食物業規例》向食肆負責人提出檢控。據悉該食肆為大家樂。

食物環境衞生署。政府新聞處圖片
署方進一步指出,這次巡查同時揭發該食肆在防鼠設施及環境衞生管理兩方面均有改善空間,因此已向食肆發出《消除蟲鼠通知》,並責成負責人須即時落實補救及改善措施,從防鼠、食物安全及環境衞生管理著手加強。食環署表明,會依據現場所見持續跟進個案,有需要時會加密覆查頻率,並採取進一步執法行動。
網上圖片
網上圖片
就網上流傳的相關影片,食環署回應稱這類影片可作為調查線索之一,惟最終是否提出檢控,須視乎個別案件的整體證據而定,當中包括事件經過、現場巡查結果、投訴人提供的資料,以及其他可取得的證據。署方重申,對每宗涉嫌違規個案均會嚴肅跟進,只要有足夠證據,便會依法檢控。
網上圖片
網上圖片
另一方面,因應近日出現的相關個案,食環署已啟動為期兩星期的「天羅行動」,重點針對超級市場、食肆,以及其他涉及食物售賣、貯存或處理的處所,加強巡查力度。署方會根據巡查結果即時要求改善、加密覆查,並依法採取執法行動。
Google 推出全新前沿 AI 模型 Gemini 4 Argon,專為處理複雜、長周期的企業工作流程而設計。這款新模型在真實世界的軟件工程、法律、金融及網絡安全防禦等專業領域展現出卓越效能,並已顯著提升 Google 內部的開發效率與工作方式。
Gemini 4 Argon
根據 Google 發布的資訊,Gemini 4 Argon 具備強大的深度推理能力。在定價方面,Argon 推出初期的輸入詞元(Token)價格為每百萬個 2 美元,輸出詞元則為每百萬個 10 美元;若使用快取輸入詞元,更可享有輸入價格的 95% 折扣。目前 Google 正透過 Fairwind 計劃,率先向受信任的網絡安全防禦專家開放該模型,並採取分階段策略,在收集早期測試者意見及完善安全防護後,將逐步開放予開發者、企業及大眾使用。
在 Google 內部應用中,Gemini 4 Argon 已協助數以千計的員工優化專業編程任務及深入研究。模型在量子演算法最佳化方面,曾在幾分鐘內將基準效能提升達 40%;在資料中心記憶體管理上,預計全面部署後可節省 500 TiB 至 1 PiB 的容量。此外,Argon 亦成功應用於大規模程式碼庫遷移,包括將高達 80 萬行程式碼的 Fuchsia Zircon 核心從 C/C++ 遷移至 Rust。在 libgav1 影片解碼器的改寫案例中,Argon 產出的安全 Rust 程式碼令執行速度較以往版本快 2.7 倍。
為瞭解決更棘手的難題,Google 將 Gemini 4 Argon 的輸出詞元上限大幅提升至 100 萬個,遠超先前的 6.4 萬個限制。這項改進為模型提供了充足的深度思考空間,使其能夠在單次推演中生成數十萬個詞元,展現出更高層次的推理能力。
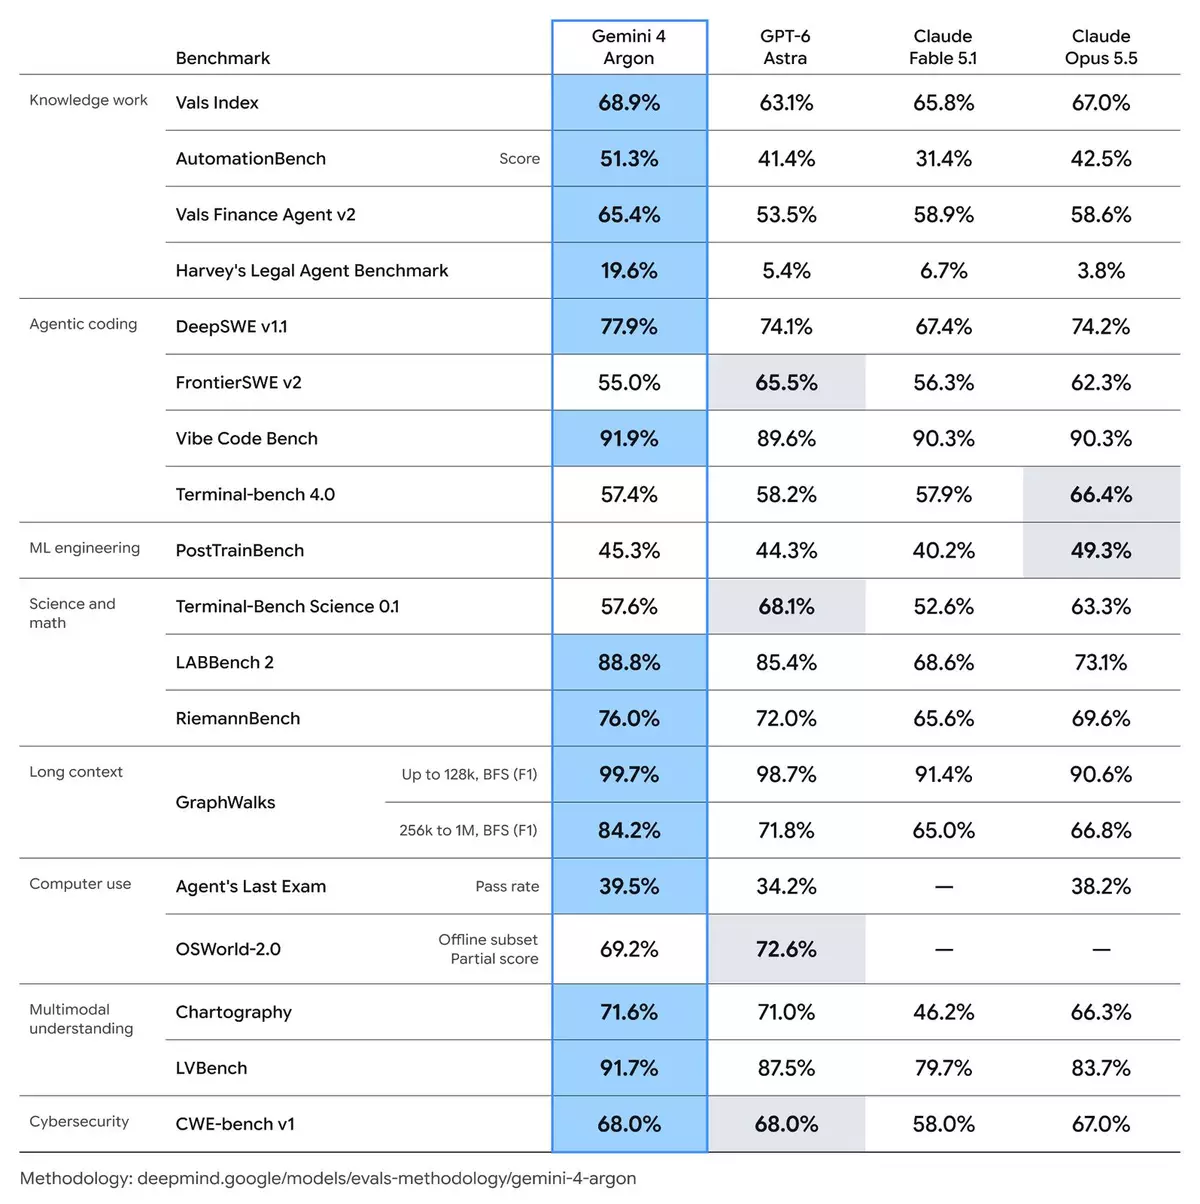
Gemini 4 Argon 在多項基準測試中展現出的領先性能對比圖表,包括 Vals Index、DeepSWE 和各項知識工作與編程評測
在各項性能基準測試中,Gemini 4 Argon 均錄得領先數據。模型在 DeepSWE v1.1 軟件工程基準測試中取得 77.9% 的得分;在評估金融、編程、法律及税務工作影響力的 Vals Index 中同樣處於領先地位。針對業務自動化的 AutomationBench 測試,Argon 以 51.3% 的得分登榜首;而在長影片理解測試 LVBench 中,更取得 91.7% 的業界領先表現。
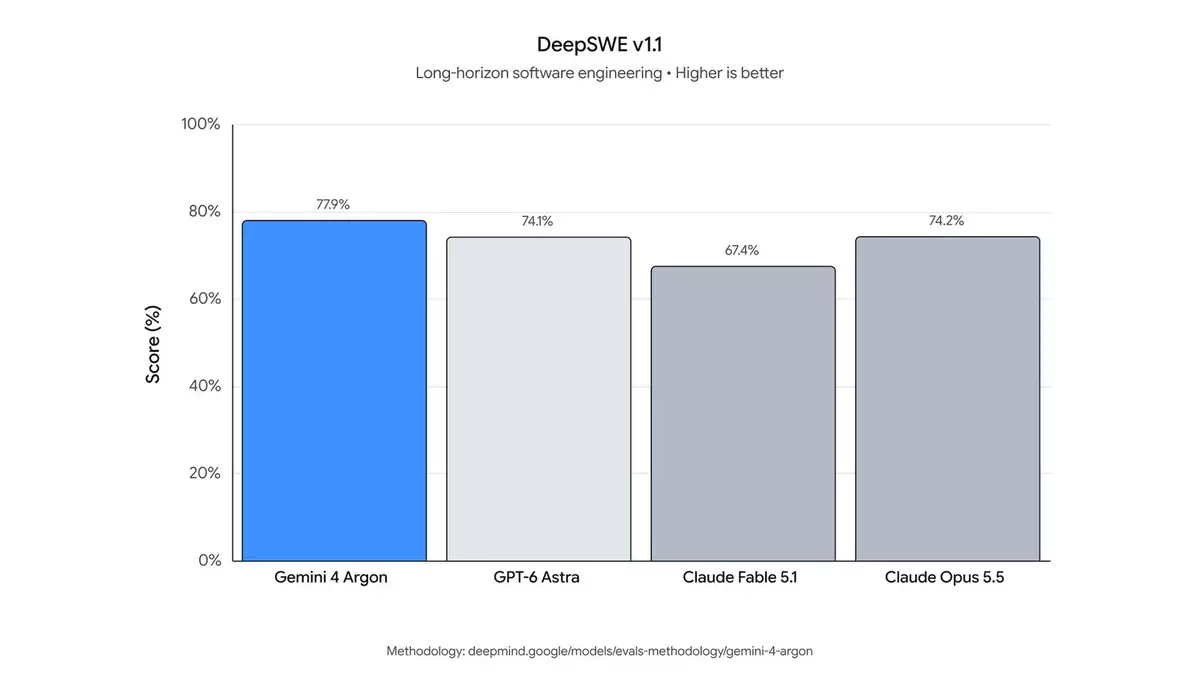
DeepSWE v1.1 基準測試圖表,顯示 Gemini 4 Argon 以 77.9% 的得分領先其他模型
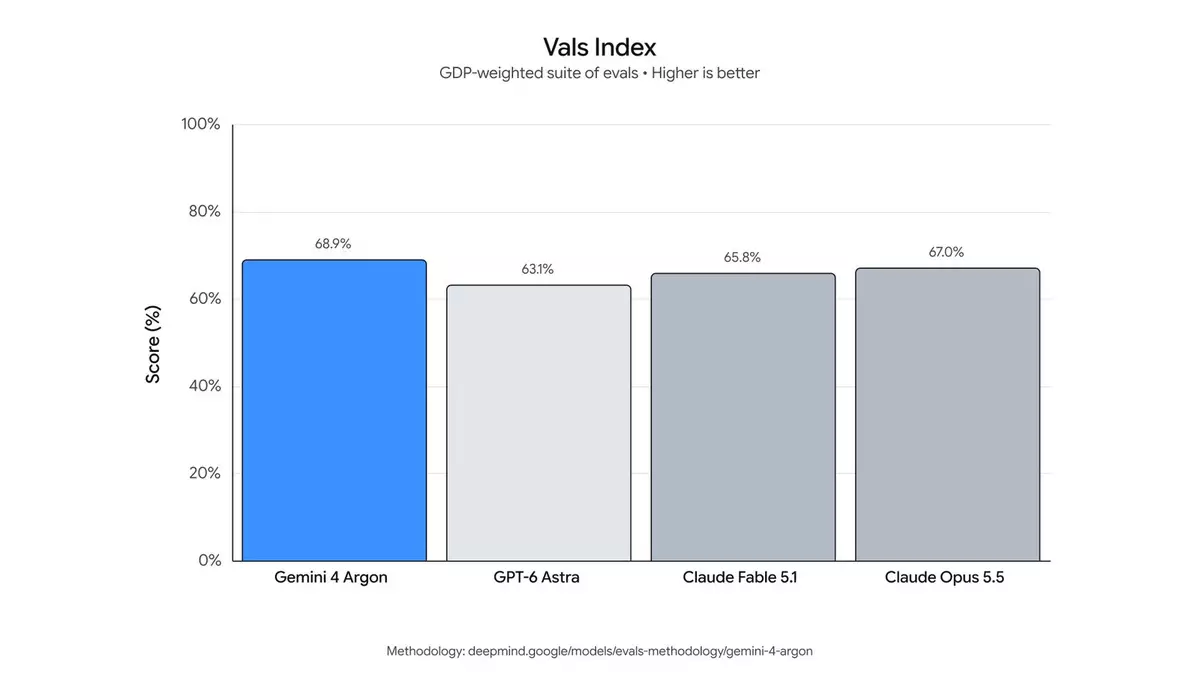
Vals Index 基準測試圖表,顯示 Gemini 4 Argon 在金融、編程、法律等工作中展現的經濟影響評分
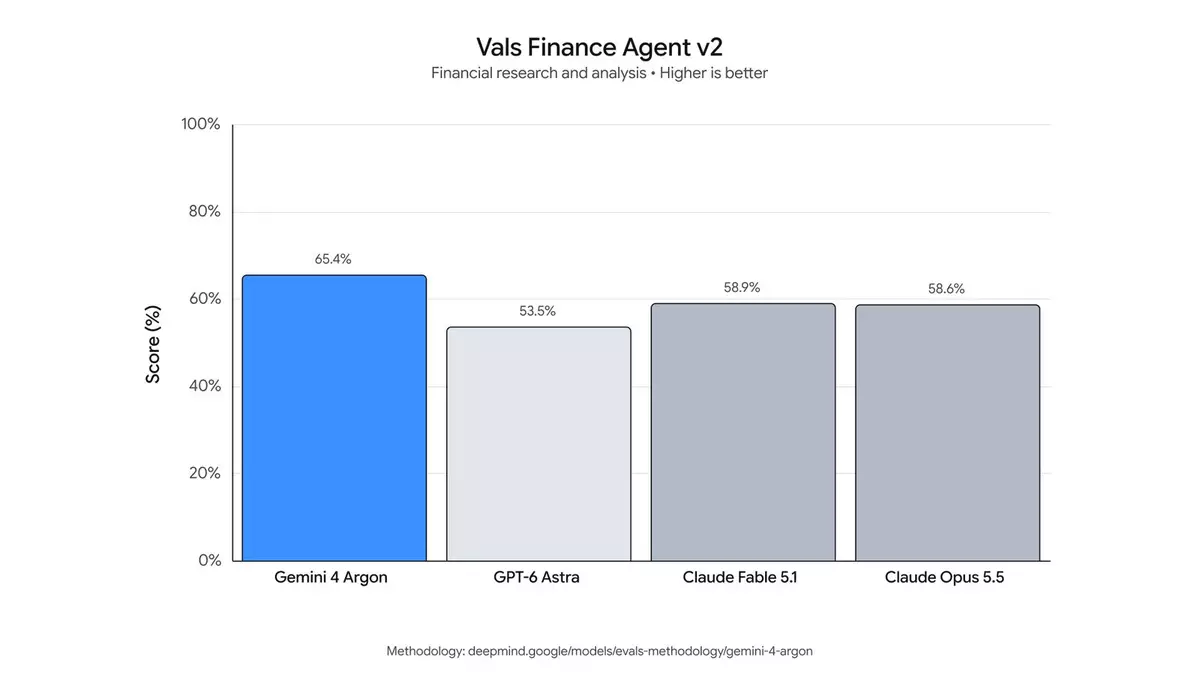
Vals Finance Agent v2 基準測試,展示 Argon 在金融研究與分析中的性能
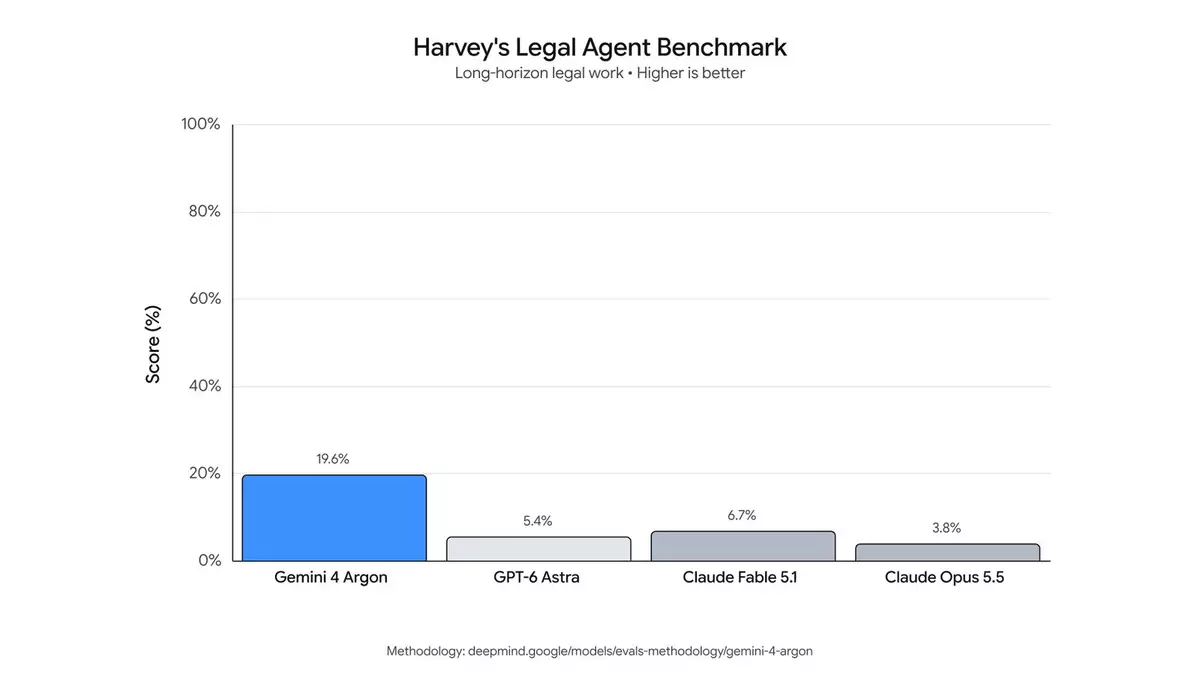
Harvey's Legal Agent Benchmark 圖表,顯示 Argon 在長週期法律工作中的領先優勢
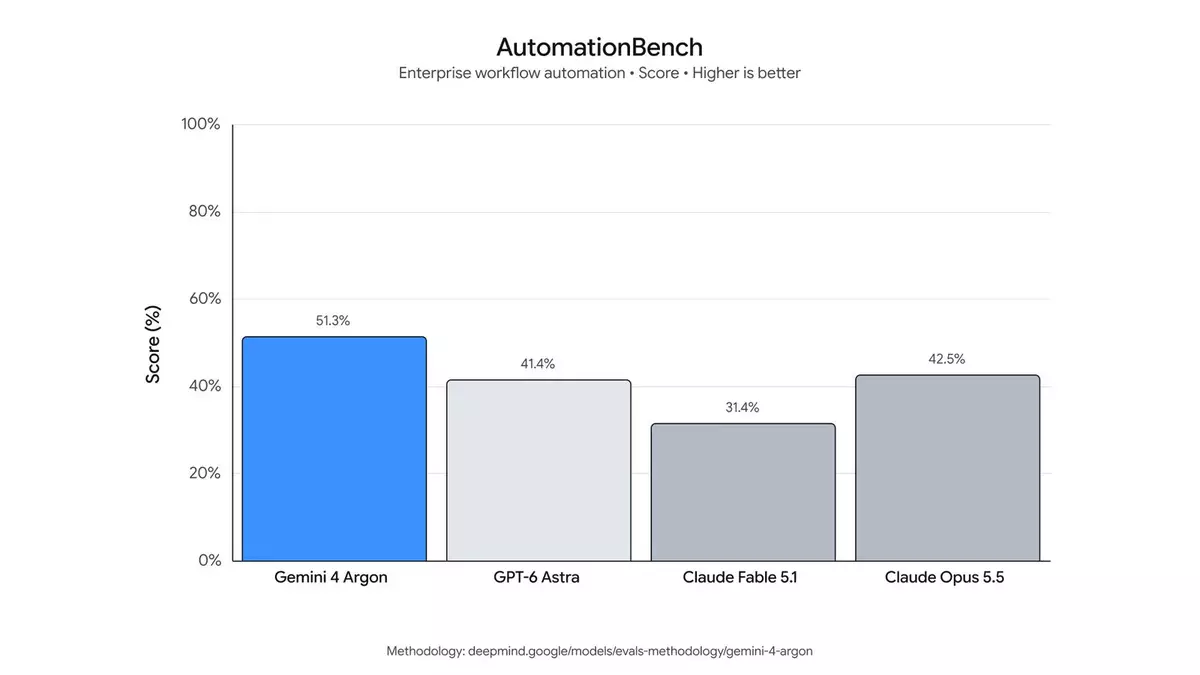
AutomationBench 測試圖表,展現 Argon 在自動化企業工作流程中的卓越得分
網絡安全防禦是 Gemini 4 Argon 的核心強化領域。該模型能自主尋找並修復關鍵軟件漏洞,在 CWE-bench v1 測試中以 68% 的高分並列首位。Google 的合作夥伴 Wiz 已將其應用於「Scan for Good」計劃,Argon 曾成功識別出一個存在於醫療保健軟件中、足以洩露全球醫院敏感個人資訊的關鍵漏洞,相關風險在以往曾被其他前沿模型遺漏。
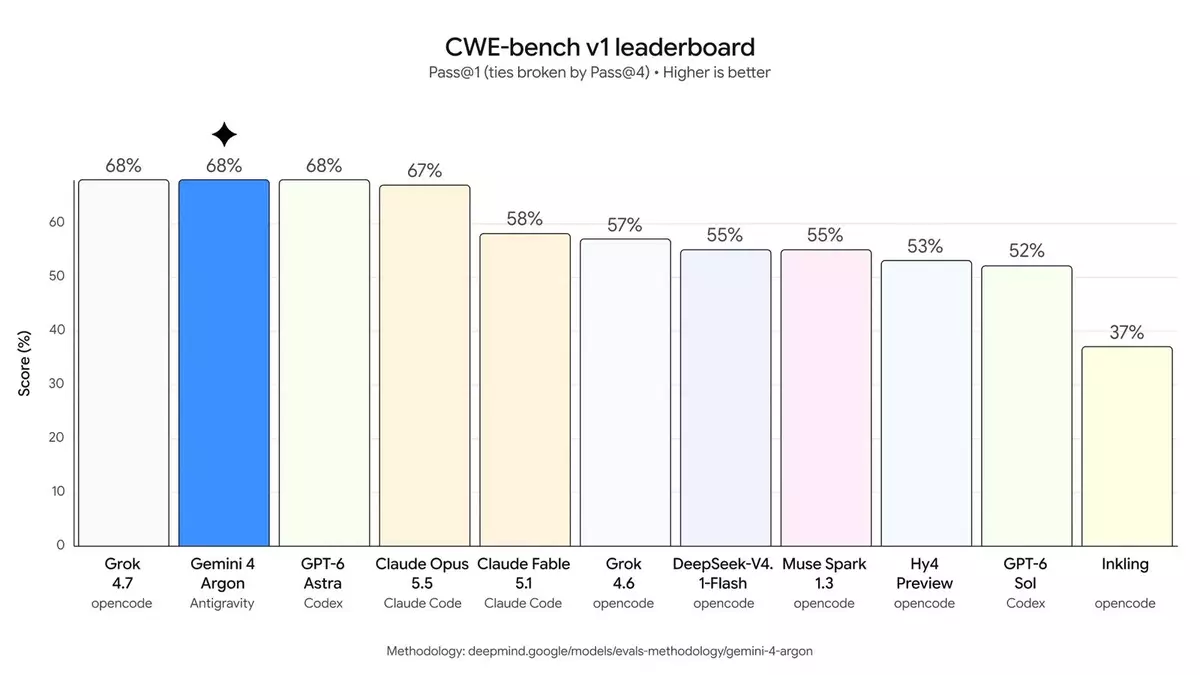
CWE-bench v1 排名表,顯示 Gemini 4 Argon 在漏洞識別與修復能力上的顯著提升
針對漏洞識別,Argon 與 3.8 Flash Cyber 相比有顯著進步。Google 內部測評顯示,Argon 能在涵蓋 20 種程式語言的複雜程式碼庫中揭露廣泛風險;而在 Wiz 的黑箱滲透測試中,其在攻擊面探測及概念驗證(PoC)生成方面的表現亦全面勝過 3.8 Flash Cyber。
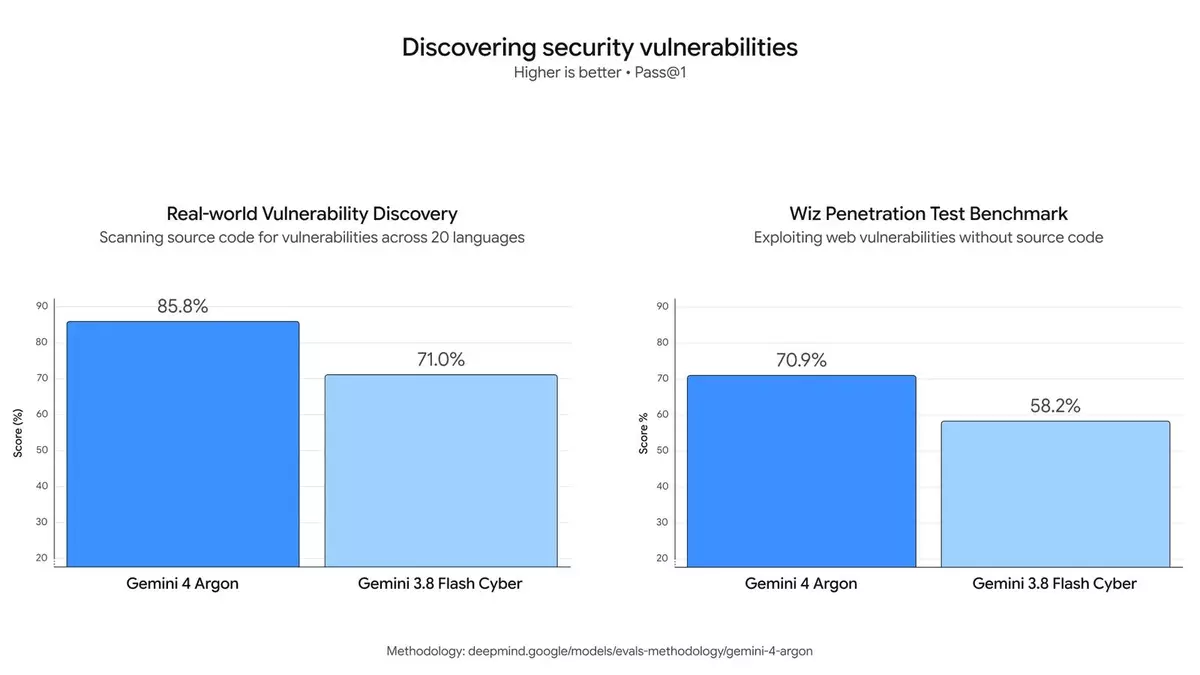
安全漏洞發現能力對比圖,顯示 Argon 在真實世界漏洞發現及 Wiz 滲透測試基準中的優秀表現
為確保前沿能力的安全釋放,Google 持續加強防護機制,包括防範網絡及 CBRN 攻擊的濫用、抵抗「提示詞注入」攻擊,以及嚴密監測對齊偏差。在 Gray Swan 的間接提示詞注入測試中,Argon 的防禦穩健性表現出色。Google 亦正強化沙盒環境的安全性,並倡導行業增加模型推理透明度,以即時中止任何偏離意圖的越界行為。
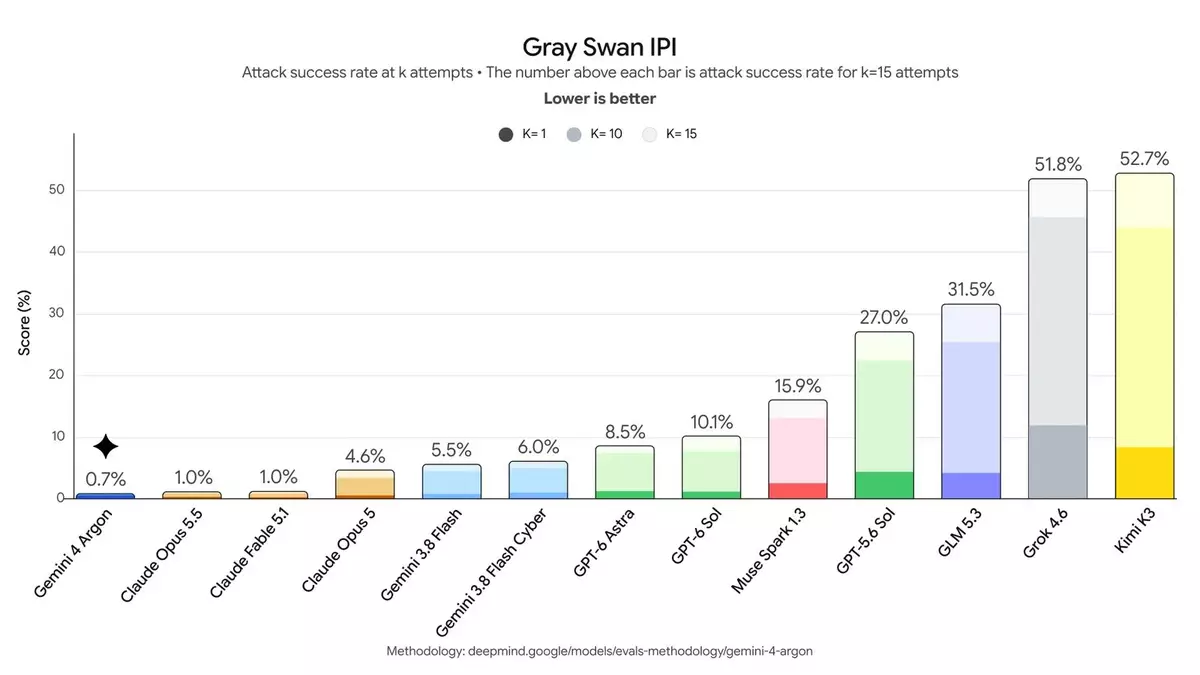
Gray Swan IPI 基準測試圖表,顯示 Argon 在防禦間接提示詞注入攻擊方面的領先安全性
Gemini 4 Argon 預計於不久後正式面世,並將優先開放予付費 API 客户及 Google AI Ultra 訂閲用户使用。這款模型結合了編程、專業知識、網絡防禦及創意寫作等多方面能力,旨在成為各領域專業人士應對高難度挑戰的理想協作夥伴。