立陶宛近日出現了一系列使用AI深偽技術製作的假新聞影片,冒充政治人物和醫生,宣稱疫苗有害,推銷健康產品。當地政府表示,這波高品質假訊息攻擊可能是跨國詐騙行動的一部分。
立陶宛出現使用AI深偽技術製作的假新聞影片
據立陶宛國家廣播電台(LRT)報導,這些使用人工智能生成的影片透過社交平台臉書傳播,仿效當地新聞節目的形式。歐洲議會議員、前立陶宛衛生部長韋瑞佳(Aurelijus Veryga)也成為受害者之一。
深偽影片中的韋瑞佳聲稱「2025年使用眼藥水就是無知」,並推銷眼部保健產品。另一支影片假冒一位當地知名醫生質疑疫苗的安全性,並推薦某藥品。
高品質的深偽技術在當地前所未見
立陶宛事實查核組織Debunk.org的負責人道克夏斯(Viktoras Daukšas)表示,研究團隊目前已發現至少20部深偽影片,並已將其封鎖。這些高品質的深偽技術在當地前所未見,這些影片使用社交平台上公開的名人影像素材,經AI合成後幾乎無法分辨真偽。

資料圖片
假訊息或已觸及歐盟約15個國家
道克夏斯指出,這些影片以疫苗危害等引人注目的標題吸引注意,通過反疫苗社群傳播,再將觀眾引導至詐騙網站進行金錢詐取,已經造成許多受害。他估計,這波假訊息已觸及歐盟約15個國家,可能有數十萬人觀看。
只需少量樣本和AI工具便可生成極具真實感的內容
立陶宛資安公司Surfshark的主管史塔穆利斯(Tomas Stamulis)表示,製作這類假影片過去需要設計師和工程團隊,現在只需少量樣本和AI工具便可生成極具真實感的內容,並且AI對立陶宛語言的掌握也迅速提升。

AI生成圖
民眾應提高媒體辨識能力
史塔穆利斯提醒,過去透過檢查影片中人物的耳朵或手指是否異常來判斷是否為深偽影像的方式已不再可靠。他建議,民眾應提高辨識能力,判斷資訊來源是否為官方網站,並留意影片中的剪輯或音訊異常等細節。

AI生成圖
立陶宛國家危機管理中心警告說,這波行動代表詐騙手法進入新階段,並批評社交平台未積極應對。中心表示曾與臉書波羅的海區代表聯繫,對方承諾加強內容審查,但目前效果有限。
專家指出,許多犯罪集團來自不與立陶宛當局合作的國家,如俄羅斯等,或是像烏克蘭這樣仍在持續戰爭、調查困難的地區,這增加了執法的難度,因此呼籲歐洲各國必須加強跨境合作。
Guava今日發布全新語音模型Daytona,並公開Guava語音指數,作為評估語音助理質素的開放式評分框架。Guava同時公布Daytona的測試結果,以及其他三個領先語音人工智能系統和真人助理處理相同通話的表現。
Guava行政總裁兼聯合創辦人Omri Dahan表示:「每間語音人工智能公司都會聲稱其助理聽起來像真人,但幾乎沒有公司會提及助理是否真正完成通話。」他續指:「我們作為買家,希望有一個這樣的指數,於是我們建立了它,並公布了我們自己的分數,包括那些需要改進的項目。」
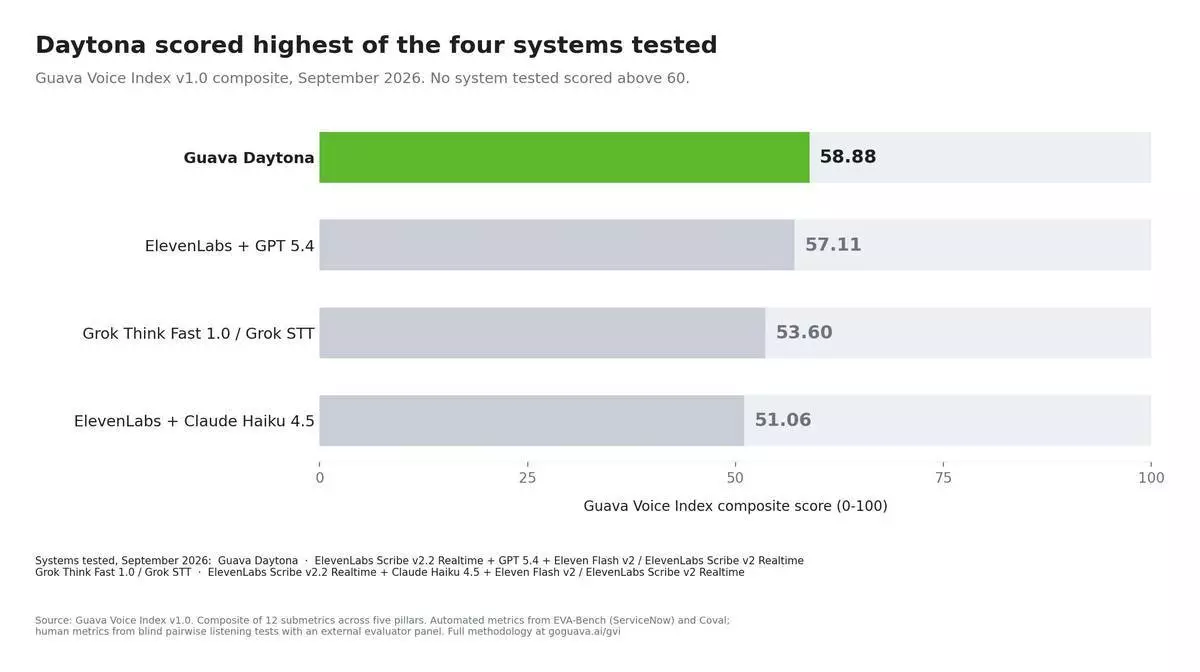
Guava語音指數v1.0綜合分數,2026年9月。Guava Daytona 58.88分,結合GPT 5.4的ElevenLabs 57.11分,Grok 53.60分,結合Claude Haiku 4.5的ElevenLabs 51.06分。 AP圖片
Guava語音指數從0到100分評估語音助理,涵蓋五大支柱:回應速度、對話流暢度、逼真度、問題解決能力及文字轉語音(TTS)質素。內容準確性佔60%權重,語音體驗佔40%。自動化評分層面參考了ServiceNow發布的語音助理評估套件EVA-Bench的組件,以及Coval語音人工智能基準測試中測量的詞語錯誤率。人工評分層面則採用盲測配對測試,由外部評估小組進行,每對至少有十名評估員。每個系統都會透過音頻聆聽測試和文字記錄審查,與處理相同通話的真人助理進行比較。Guava已於goguava.ai/gvi公布完整的評估方法、支柱權重及驗證門檻,以便外界審查評分。
Guava聯合創辦人兼工程主管Anthony Scodary指出:「大部分語音基準測試都非常狹窄,僅限於語音轉文字、文字轉語音或非常簡短的模擬對話。Guava語音指數(GVI)則涵蓋真實對話,並結合機器與人工評估員。我們相信這是新的黃金標準。」
於2026年9月測試的四個系統包括Guava Daytona、結合GPT 5.4的ElevenLabs、Grok,以及結合Haiku 4.5的ElevenLabs。
Daytona以58.88分(滿分100分)取得最高分數,領先結合GPT 5.4的ElevenLabs(57.11分)、Grok(53.60分)及結合Haiku 4.5的ElevenLabs(51.06分)。沒有任何系統得分超60分。Daytona在逼真度、人工評估語音質素及回應時間方面表現領先。然而,它並非在所有方面都佔優:結合GPT 5.4的ElevenLabs在問題解決能力方面得分較高,取得79%可用分數,而Daytona則為67%。兩項結果均已公布。
每個系統亦與處理相同通話的真人助理進行比較。在所有四個受測系統(包括Daytona)中,評估員在回應時間方面有91%的比較偏好真人助理,在打斷後恢復對話方面則有93%偏好真人助理。
Guava自行建立及營運堆疊中的每個模型,從語音識別到語音合成。自2013年以來,Guava的模型已透過超100個生產部署,訓練了超100億分鐘的真人助理對話。該公司已獲SOC 2 Type II認證、HITRUST i1認證及符合PCI DSS Level 1標準,並為醫療保健部署提供業務夥伴協議(BAA)。
Daytona現已供Guava客戶使用。Guava語音指數及完整排行榜已於goguava.ai/gvi公布,並將隨着新系統測試而更新。
(美聯社)