
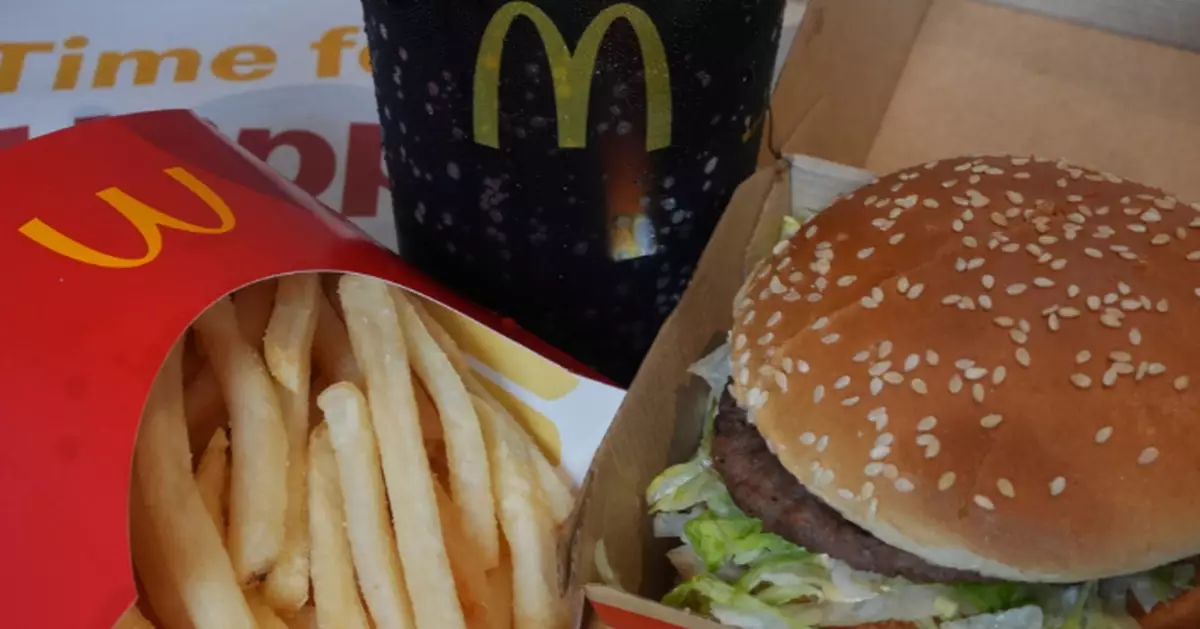
在美國加州弗雷斯諾市,相距約三公里的兩家麥當勞門市,同款巨無霸一家賣5.69美元,另一家賣6.89美元,價差超過兩成。雖然無法確認這個價差是否來自AI定價系統的建議。但麥當勞近年正積極導入AI,估算各店顧客願意付多少,再據此建議售價。
McDonald's pushes AI tools that suggest Big Mac prices based on 'customer willingness to pay' https://t.co/vF47sZ9otq pic.twitter.com/GKzAw2nalA
— New York Post (@nypost) September 29, 2026
據外媒報道,這套系統透過機器學習,分析全美近1.4萬家門市每天數百萬筆交易,為每家店的每項商品建議所謂的「最佳價格」。螢幕畫面截圖顯示,系統會告訴加盟商,當地顧客對價格的敏感程度,例如「你的餐廳對價格呈現中等敏感度」,而這項判斷部分依據「你所在地區顧客的付費意願」。
平台也會抓取溫蒂漢堡(Wendy’s)、漢堡王(Burger King)等競爭對手的線上菜單價格,做為參考。有加盟商表示,系統已拉大同一商品在不同門市之間的價差,有時連同一區域內不同社區之間,價差也擴大。這也是消費者的疑慮所在。如果系統判斷某地顧客比較能接受漲價,當地售價可能就會被調高。買同款漢堡,可能因為地點而必須多付錢。
AP圖片
麥當勞總部與加盟商之間的利益未必一致,有時會出現矛盾。總部主要收入來自按加盟店總營收抽成。降價若能吸引更多人上門、增加總營收,即使單店利潤變薄,總部仍可能受益。加盟商面對工資、租金上漲,則更有理由調高價格來維持利潤。
AP圖片
AI並非一味喊漲。部分加盟商表示,系統在疫情期間及之後曾建議大幅漲價,近幾個月卻轉趨保守,甚至建議降價,也因此引發部分加盟商與總部之間的摩擦。
AP圖片
麥當勞強調,這套系統只是協助做決定的工具,加盟商可自由決定最終售價。但有加盟商表示,確實遭施壓要求採用AI定價工具。一份6月的內部文件顯示,麥當勞總部會詳細記錄加盟商偏離建議價格的情況。今年1月起,麥當勞也要求加盟商積極配合公司核准的定價顧問與工具。
AP圖片
2023年,康乃狄克州一家州際收費公路旁的麥當勞,曾因巨無霸套餐賣約18美元,引發消費者強烈不滿。加盟商在訴訟中表示,這個價格是定價工具建議的,他後來在法院文件中稱,這個價格「並未造成銷售損失」。
更敏感的是法律風險。麥當勞在定價平台的服務條款中提醒,加盟商「彼此之間可能是競爭者」,使用工具時,充分理解並遵守反托拉斯與競爭法規格外重要。
AP圖片
喬治華盛頓大學競爭法中心主任柯瓦契奇(William Kovacic)認為,這段文字「等於承認存在潛在問題」。美國法院與監管機關正在檢視,演算法定價是否可能促成競爭業者非法協調價格。不過,其他專家認為,麥當勞的法律風險較低,因法院近幾十年來容許品牌在很大程度上左右加盟商的定價。麥當勞也表示,條款中的提醒不代表存在反競爭行為。
AP圖片
紐約布魯克林居民Diane Bezucha表示,企業想知道哪裡有需求、即時取得回饋,符合公司利益;但如果科技是被用來因應需求增加而調漲價格,「對我這個顧客而言並沒有什麼幫助」。