人工智能工廠平台公司Penguin Solutions(納斯達克:PENG)今日宣布,將參與於九月十五至十七日在聖克拉拉會議中心舉行的AI Infra Summit 2026。Penguin將在五二零號展位舉行產品示範,並在會議期間發表演講。
AI Infra Summit匯聚業界專業人士,他們代表人工智能基礎設施堆疊的各個層面,包括運算、記憶體、互連、網絡層等,共同應對推論及代理式人工智能日益增長的需求。
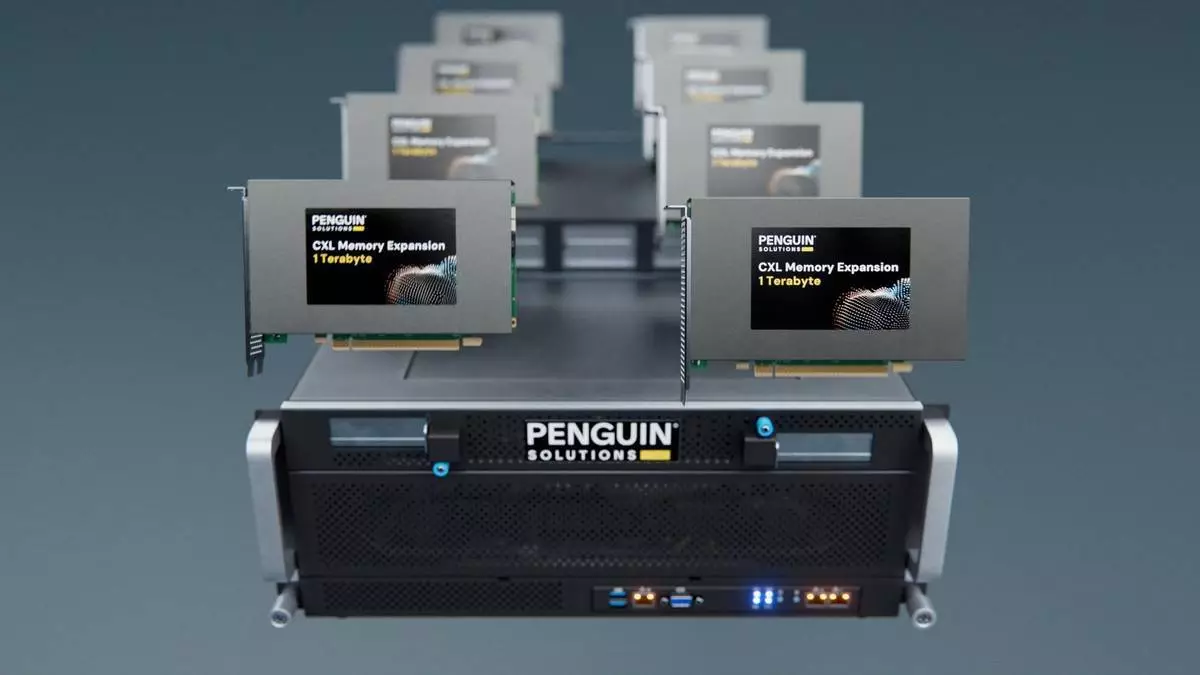
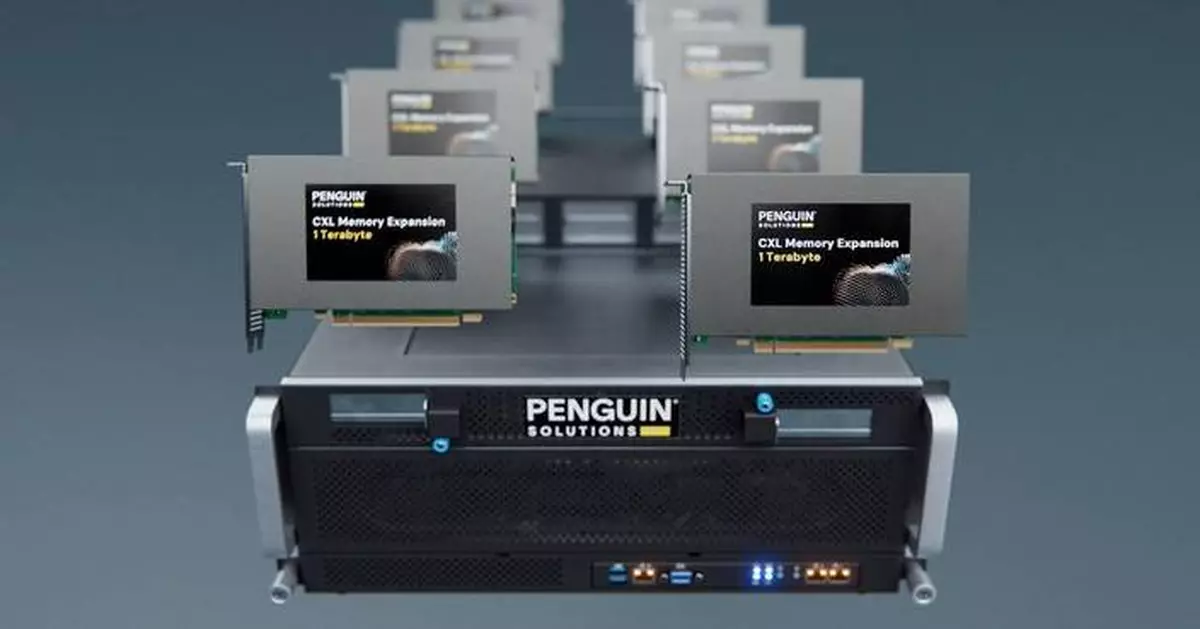
Penguin Solutions MemoryAI KV快取伺服器利用CXL記憶體技術,解決人工智能推論中關鍵的「記憶體瓶頸」挑戰。這項創新解決方案提供超11 TB的CXL記憶體,旨在優化企業級推論(包括代理式人工智能)的效能。 AP圖片
隨著企業從人工智能訓練轉向推論及代理式工作負載,其存取數據的速度及準確性,日益決定運行這些工作負載的成本。Penguin正透過其全棧人工智能工廠平台解決這項限制,該平台包括其MemoryAI KV快取伺服器,旨在提升大型語言模型推論的效能,並協助機構實現可量化的投資回報。
活動資訊:
演講環節:
技術示範:
Penguin將在其五二零號展位展示多項示範,讓參與者親身體驗其創新的人工智能解決方案。
MemoryAI是Penguin Solutions, Inc.的註冊商標。所有其他商標均為其各自擁有者的財產。
關於Penguin Solutions
Penguin Solutions是人工智能工廠平台公司。我們為企業、主權人工智能計劃及新雲端供應商設計、建造及管理新一代數據中心。
憑藉在數據中心人工智能基礎設施及記憶體解決方案交叉領域的深厚設計專業知識,我們的全棧人工智能工廠平台結合差異化的基礎設施軟件、先進記憶體、運算系統、端到端服務及業界領先的合作夥伴技術,以協助客戶加快部署、優化代幣經濟,並最大限度地提高其人工智能投資的回報。
(美聯社)
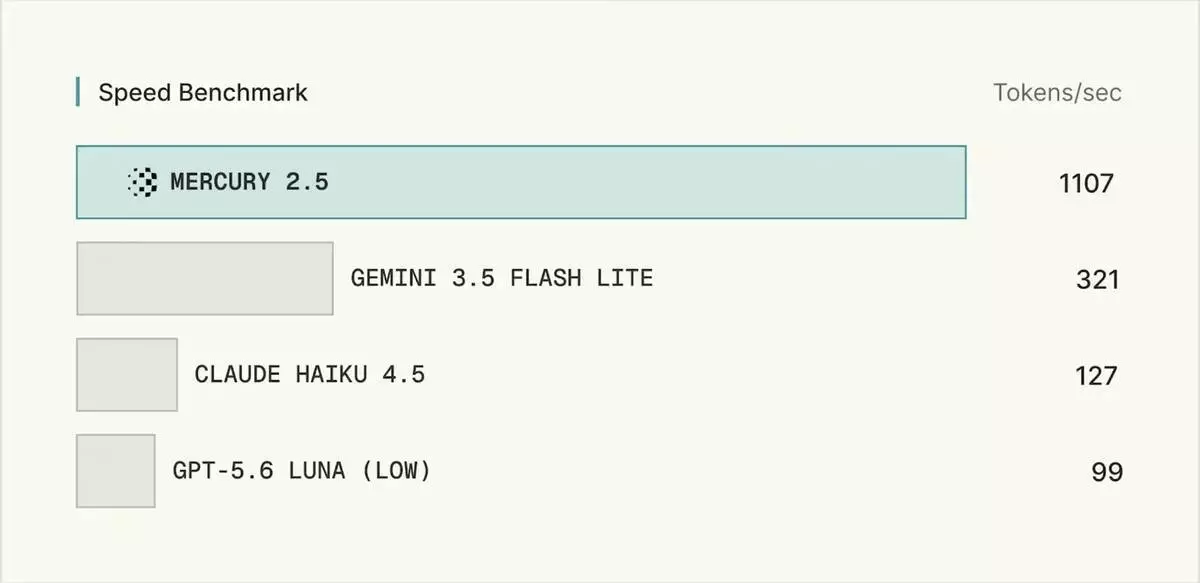
Inception公司今日宣布推出Mercury 2.5。該公司是首個商用擴散式大型語言模型(dLLM)的開發商。Mercury 2.5是目前生產中最具能力及推理速度最快的dLLM。Mercury 2.5為dLLM帶來更高層次的智能,在生產環境下每秒可處理超1,100個詞元。
現時大部分生產中的大型語言模型,仍以自迴歸方式逐個詞元生成文本。這種方法將成本及延遲直接與推理深度掛鈎,模型思考得越多,速度便越慢,成本亦越高。dLLM的運作方式不同,它會先生成輸出的草稿,然後並行地精煉詞元。
Inception推出Mercury 2.5,為擴散式大型語言模型帶來更高層次的智能。 AP圖片
dLLM已從研究階段的嘗試,發展成為生產環境中的主力。企業對Mercury的使用量正以超十倍的速度增長,大規模地支援搜尋、語音及編碼代理。Inception透過Mercury 2證明擴散式模型已為企業應用做好準備,其智能水平與Claude Haiku及GPT Mini相若,但吞吐量卻高出約十倍。自此,Mercury模型已成為那些不願犧牲智能換取速度,或犧牲速度換取成本的團隊首選dLLM。Mercury 2.5直接建基於此基礎:提供更高智能、更低成本,並較傳統模型有相同的速度提升。
Inception行政總裁兼聯合創辦人埃蒙表示:「業界沒有人認為大型語言模型可以同時變得更智能、更快、更便宜。這是自迴歸建模的局限。Mercury 2.5證明轉用擴散式模型可開啟這扇門。」
詞元效率
隨着人工智能基礎設施成本上升,數據中心難以應付需求,詞元效率受到比一年前更嚴格的審視。每個詞元均涉及運算、電力及數據中心容量成本,而自迴歸模型在逐個詞元生成時,會耗用這三項資源。dLLM能更有效地利用每個圖像處理器週期,每一步生成多個詞元而非一個,意味每單位成本可獲取更高智能。這種效率可在廣泛使用的英偉達圖像處理器上運行,而非專用晶片。
更智能,不減速
Mercury 2.5的智能水平較Mercury 2提升十點,使其超越所有以往的dLLM,可媲美GPT-5.6 Luna、Gemini 3.5 Flash-Lite及Claude Haiku 4.5等成本優化型前沿模型。吞吐量增至每秒超1,100個詞元,定價降至每百萬詞元0.20美元/0.75美元。推出時,Mercury 2.5提供八折優惠,每百萬詞元僅0.04美元/0.15美元。Mercury 2.5將上下文窗口擴展至260K詞元,較原來的128K有所增加,並新增可調推理、原生工具使用、JSON模式及並行工具調用功能。
OpenCall聯合創辦人兼行政總裁西爾弗斯坦表示:「轉用Mercury後,我們的P99響應時間從數分鐘降至僅一秒,P50則從0.4秒降至不足0.2秒,較市場上包括推理功能在內的其他供應商更快。」
擴散式模型蓬勃發展的領域
Mercury dLLM已在要求響應式推理的工作負載中投入生產:
除Mercury 2.5外,Inception亦宣布推出Mercury Voice及Mercury Router的預覽版。Mercury Voice可在170毫秒內提供首個詞元時間(TTFT),是一款為延遲預算最嚴格的語音代理優化的dLLM。Mercury Router則利用dLLM理解輸入提示,並將其路由至提供最佳質量、速度及成本組合的模型(包括開源及閉源模型)。有興趣的客戶可聯絡sales@inceptionlabs.ai以獲取Mercury Voice及Mercury Router的預覽權限。
Mercury 2.5已為企業應用做好準備,現已透過Inception的API、OpenRouter及Baseten提供。用戶可獲取一億個免費詞元以開始使用。
關於Inception
Inception開發基於擴散式的大型語言模型(dLLM),旨在實現高效、低延遲的人工智能應用。傳統的自迴歸式大型語言模型按順序生成文本,而Inception的擴散式模型則並行生成輸出,從而為搜尋、語音及編碼代理等實時應用場景提供更快的推理速度及更高的可靠性。Inception的Mercury模型可透過Inception API、OpenRouter及Baseten獲取。Inception總部設於加州紅木城,獲Menlo Ventures、Mayfield、Innovation Endeavors、M12(微軟的風險投資基金)、Snowflake Ventures、Databricks Ventures等機構,以及吳恩達、安德烈·卡帕西及埃里克·施密特等個人投資者支持。如欲了解更多資訊,請瀏覽www.inceptionlabs.ai。
(美聯社)