達梭系統與維諦控股公司今日宣布合作,旨在令人工智能工廠的基礎設施可在施工前進行配置、模擬及驗證。兩間公司結合達梭系統的3DEXPERIENCE智能平台與維諦的關鍵數碼基礎設施專業知識,目標是減少現場複雜性,並加快輝達DSX人工智能工廠從設計啟動到具生產力人工智能容量的進程。
這次合作建基於維諦SmartRun可配置虛擬雙生技術,並將模型化方法擴展至更廣泛的維諦人工智能工廠基礎設施解決方案,當中包括Vertiv OneCore。達梭系統的3DEXPERIENCE平台提供系統工程、模擬及虛擬雙生功能,以配置及驗證維諦預先設計的SimReady人工智能工廠供電及散熱參考設計。這些設計基於輝達Vera Rubin DSX人工智能工廠參考設計及輝達Omniverse DSX藍圖。
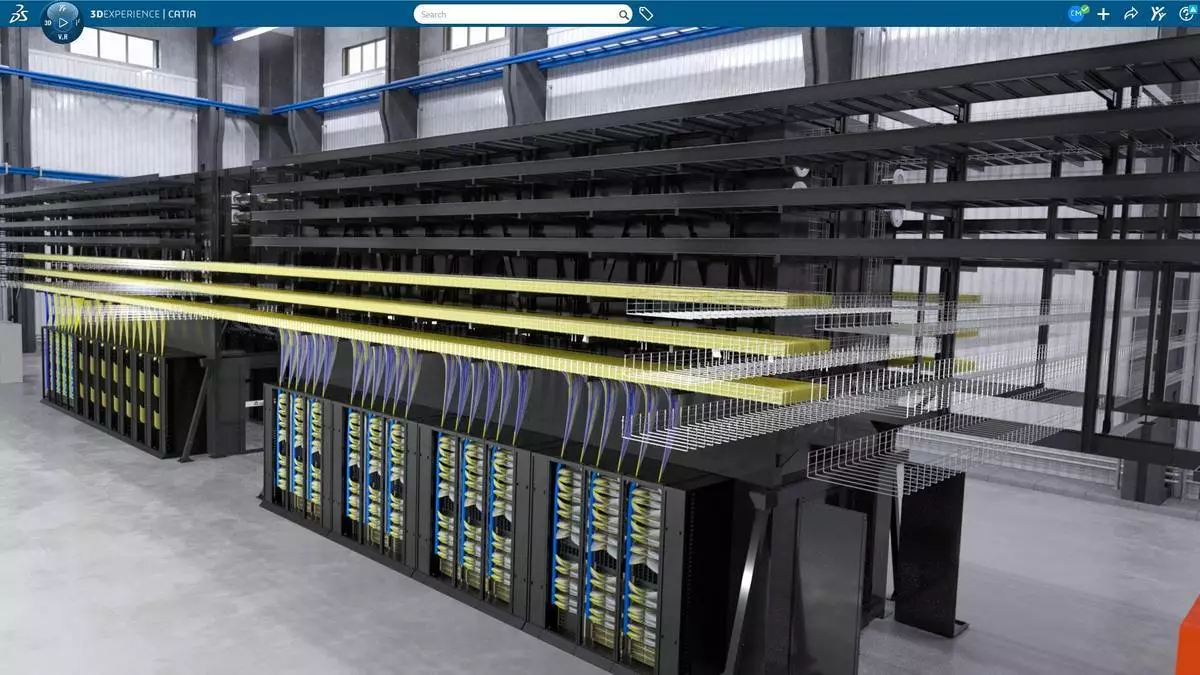
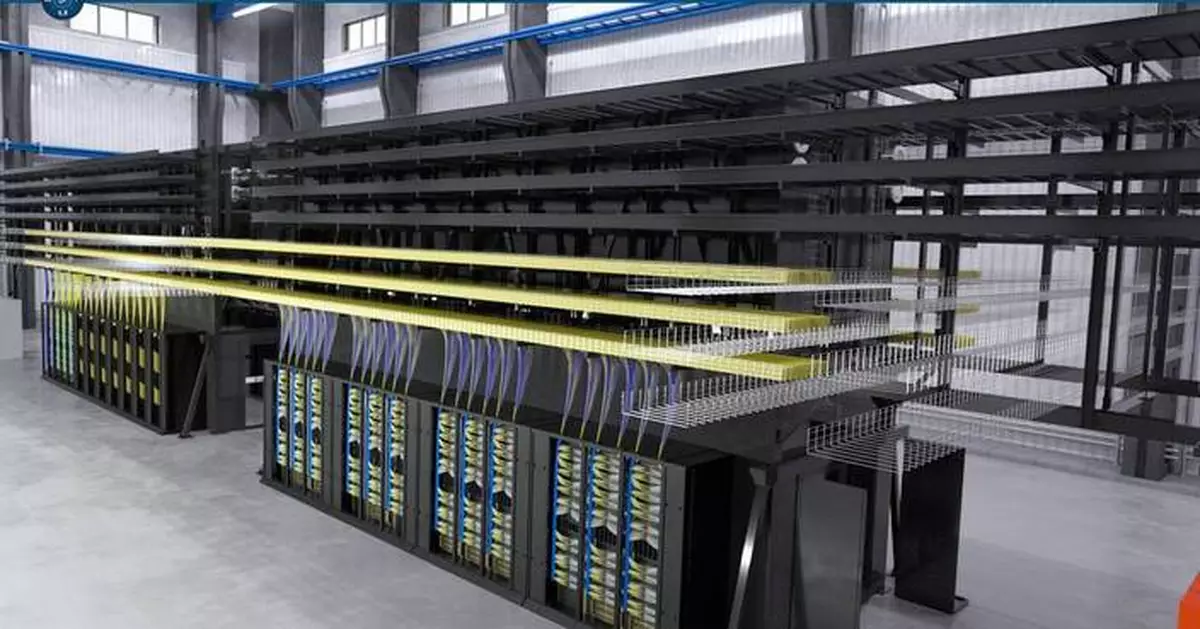
維諦人工智能工廠設備數據,透過達梭系統的3DEXPERIENCE平台在虛擬雙生中呈現。(圖片:達梭系統及維諦) AP圖片
人工智能工廠是高度耦合的系統,其供電、散熱、網絡、控制及運算必須協同設計。因為一個領域的變化可能對其他領域產生重大影響。這要求工程師在系統建造及部署前,了解並驗證整個基礎設施系統的運作表現。
Vertiv OneCore是一種混合式數據中心解決方案,整合了關鍵供電、熱管理及支援基礎設施。3DEXPERIENCE平台的模型化系統工程、模擬及虛擬雙生功能,可將維諦的基礎設施呈現為一個整合的數碼系統,提供設計變更影響的可追溯性及可視性。
透過使用3DEXPERIENCE平台,維諦SimReady供電及散熱資產成為可配置的系統模型。這些模型可作為客戶專屬人工智能工廠配置的起點,並基於輝達Vera Rubin DSX人工智能工廠參考設計及輝達Omniverse DSX藍圖。模型化方法並非創建固定設計,而是讓工程師能夠評估配置、跨學科傳播設計變更、執行系統級及多物理場驗證,並從共同環境中生成工程交付成果。
這種方法推動工程邁向可配置、持續協同設計及驗證的人工智能工廠基礎設施。它從早期配置到施工、調試及未來技術升級,均保留設計意圖。
目標客戶成果包括將從需求到配置及驗證人工智能工廠解決方案的進程,加速高達10倍,並將基礎設施部署期縮短高達50%。根據維諦模型中的假設,這種結合方法可比傳統基準模型提早約10個星期投入運作,並在項目啟動後12個月內,以相同裝機容量生產增加高達30%的累計代幣輸出。這次增益僅源於設施提早準備就緒,並不反映營運效率的提升或實際客戶成果。
維諦首席產品及技術總監斯科特·阿姆爾指出:「人工智能領域的贏家,將是那些能最快將運算能力轉化為生產力的人。這要求整個人工智能工廠作為一個系統運作,涵蓋運算、供電、散熱及實體基礎設施。透過結合維諦預先設計的基礎設施專業知識與達梭系統的模型化功能,我們可以在施工前配置及驗證該系統,減少現場複雜性,並協助客戶更快地將人工智能容量投入運作。」
達梭系統策略、行業、市場推廣及轉型執行副總裁艾麗莎·普里斯納表示:「人工智能工廠是現今正在建造中最複雜的工程系統之一。這種複雜性要求系統視角——在整個工廠建成之前,在虛擬雙生中進行建模、模擬、協調及優化。我們與維諦攜手,將標準化的基礎設施知識轉化為輝達DSX人工智能工廠的可配置虛擬雙生。我們的3DEXPERIENCE平台讓客戶能夠探索配置、了解設計決策的後果,並在任何基礎設施實體存在之前,虛擬驗證整個系統的性能。」
在10月20至22日舉行的輝達GTC柏林大會上,兩間公司將展示設計及部署方法的部分內容。這將示範設施要求如何影響基礎設施配置、團隊如何虛擬評估供電及散熱限制,以及維諦如何應用工廠預製基礎設施以加速實體部署。這次示範將結合輝達Vera Rubin DSX人工智能工廠參考設計、輝達Omniverse DSX藍圖、達梭系統的3DEXPERIENCE平台及模型化系統工程功能,以及維諦SimReady供電及散熱資產。
關於達梭系統:達梭系統是人類進步的催化劑。自1981年以來,該公司開創虛擬世界,以改善消費者、患者及公民的現實生活。透過3DEXPERIENCE智能平台,人工智能驅動、基於科學的虛擬雙生技術,協助各行各業39萬名客戶協作、構想及創造可持續創新,從而產生有意義的影響。
關於維諦控股公司:維諦控股公司整合硬件、軟件、分析及持續服務,使其客戶的關鍵應用程式能夠持續運行、最佳表現並隨業務需求增長。維諦透過一系列從雲端到網絡邊緣的供電、散熱及資訊科技基礎設施解決方案及服務,解決現今數據中心、通訊網絡及商業與工業設施面臨的最重要挑戰。維諦總部位於美國俄亥俄州韋斯特維爾,業務遍及超130個國家。
(美聯社)
人工智能基礎設施及液冷解決方案供應商凱圖斯(KAYTUS),在ISC 2026推出新一代智能基礎設施管理平台KSManage Ultra。該平台專為人工智能工廠而設,旨在為最新高密度人工智能機櫃提供統一智能管理。
「KSManage Ultra」可對運算托盤、交換機托盤、配電單元(PDU)及冷卻分配單元(CDU)等關鍵機櫃級組件,進行統一智能管理。透過端到端可視性、性能級診斷及自動化操作,該平台將高度耦合的人工智能基礎設施,從碎片化監管轉變為整合的系統級操作,協助企業構建更高效、可靠及可持續的人工智能基礎設施。
「KSManage Ultra」人工智能工廠專用。 AP圖片
凱圖斯指出,傳統人工智能操作面臨三大挑戰。首先,管理複雜性急劇上升。人工智能工廠的基本單位不再是單一伺服器,而是資源耦合的高密度人工智能機櫃。單一機櫃整合多個深度協調的子系統,包括運算、網絡、供電及液冷。與傳統4U 8個圖形處理器(GPU)部署相比,NVL72機櫃級系統整合近百個加速器及數千個高速互連。在100千瓦級機櫃中,功率密度可高出約兩至三倍,熱管理亦變得更複雜,涉及冷卻液分配、冷卻分配單元(CDU)、流量及相關安全控制。隨着人工智能工廠規模持續擴大,操作複雜性急劇增加,任何單一組件的波動都可能影響整個機櫃的性能及穩定性。
其次,故障識別已超越硬件層面。人工智能訓練及推理工作負載對性能波動高度敏感,隱藏異常可顯著降低操作效率。與傳統與停機相關的故障不同,人工智能系統的性能下降通常靜默發生。由於這些性能問題與底層硬件及基礎設施狀況密切相關,僅依賴來自工作負載或基礎設施的獨立數據,難以識別真正的根本原因。
第三,隨着部署規模擴大,人工智能工廠面臨日益嚴峻的操作效率危機。傳統逐個設備上線效率低下,減慢部署速度並增加配置不一致的風險。同時,傳統配置方法耗時且容易出錯。每個AI機櫃內整合多種設備類型,即使輕微配置偏差亦可能導致整個集群的性能下降或服務中斷。
凱圖斯表示,傳統操作模式依賴人手流程或碎片化工具,往往導致部署延遲、故障排除困難及配置不一致,限制人工智能應用程式的開發及大規模採用。為簡化人工智能數據中心的操作及管理,凱圖斯推出「KSManage Ultra」。該平台透過連接帶內及帶外管理路徑,並將資訊科技基礎設施狀態與實體基礎設施狀況關聯,實現跨組件、節點、機櫃、集群及數據中心層面的整個基礎設施堆棧整合管理。這代表操作從被動響應轉變為主動預警,協助客戶在複雜的人工智能工廠環境中,構建監控、診斷、故障隔離及全面恢復的智能操作能力。
「KSManage Ultra」提供人工智能數據中心操作狀態的單一視窗全球可視性,為傳統基礎設施及先進人工智能機櫃系統提供全堆棧統一管理。該平台為圖形處理器(GPU)、中央處理器(CPU)、記憶體、高速交換模組、管理網絡、電源架、冷卻分配單元(CDU)、液冷系統、機櫃及集群資源提供集中管理。透過打破資訊科技與實體基礎設施之間,以及單個組件與整個機櫃之間管理界限,「KSManage Ultra」創建跨組件、節點、機櫃、集群及整個數據中心的多層次資源視圖。
透過統一平台,客戶可避免重複切換多個系統,並快速評估資源健康狀況、機櫃可用性及集群準備狀態,以實現高效生產部署及操作。「KSManage Ultra」整合帶內數據(包括操作系統、驅動程式、應用程式及性能)與帶外數據(例如BMC、韌體、電源、溫度及硬件日誌),以及基礎設施數據到單一統一管理系統。它可實現跨操作狀態、硬件健康、鏈路拓撲、供電及液冷狀況的關聯分析,將操作從被動響應轉變為主動預警。當系統檢測到圖形處理器(GPU)異常、鏈路質量下降、液冷波動或節點健康狀況下降時,可主動識別有風險的節點,並引導客戶隔離、維護或重新配置資源,協助防止故障節點進入關鍵任務運行。
以液冷監控為例,「KSManage Ultra」支援節點、機櫃及迴路三級洩漏檢測。一旦檢測到洩漏風險,平台可協調安全關機、電磁閥關閉及節點隔離,同時觸發電郵警報、工單生成及閉環修復。這協助客戶為人工智能機櫃系統構建系統級主動操作能力。
「KSManage Ultra」專為多機櫃部署場景而設,提供資源健康識別及故障隔離能力。平台持續評估節點及機櫃健康狀況,基於圖形處理器(GPU)狀態、記憶體及PCIe狀態、網絡鏈路質量、韌體一致性、液冷狀況及供電狀態等指標。當檢測到異常節點或高風險組件時,系統可應用智能標記,分析潛在影響範圍,並啟動隔離操作,協助防止故障節點進入關鍵任務運行。
「KSManage Ultra」協助客戶建立清晰的可用資源視圖,包括應從服務中移除的節點、仍適合組合使用的機櫃、準備好用於訓練及推理工作負載的資源,以及應進入維護程序的資源。因此,客戶可超越故障發生後的被動修復,持續維持穩定的運算健康區,提高人工智能工廠的業務連續性及資源利用率。
「KSManage Ultra」支援一鍵批量掃描及自動添加節點。透過智能識別設備序列號及IP地址,平台自動建立節點與機櫃之間的拓撲映射,將單機櫃上線時間從傳統的50分鐘縮短至不足3分鐘。「KSManage Ultra」支援L10及L11級別的一鍵批量壓力測試,將故障根本原因定位時間從數小時縮短至數分鐘。平台亦可實現機櫃級自動化初始化及配置,包括驅動程式安裝、硬件配置及軟件部署,所有這些都可根據模板批量交付。透過顯著提高操作效率,同時協助維持同一集群內硬件環境的一致性,「KSManage Ultra」有效降低因配置漂移導致性能波動或任務失敗的風險。
作為人工智能工廠的全面統一平台,「KSManage Ultra」具備開放且高度兼容的架構。透過開放應用程式介面(API),它可無縫整合調度平台及配置管理數據庫(CMDB)等上層系統,同時亦提供伺服器、網絡設備、供電基礎設施及冷卻系統等下層異構設備的統一管理。這可實現整個數據中心環境的集中管理。「KSManage Ultra」旨在協助企業實現異構基礎設施的統一管理及智能操作,為人工智能工廠穩定高效運行奠定堅實基礎。
來源:
1. 傳統HGX H100/H200 4U 8個圖形處理器(GPU)伺服器每個42U機櫃通常支援4至8個單元,導致機櫃級功耗約為40至80千瓦。相比之下,GB200 NVL72機櫃可超120千瓦,功率密度約增加兩至三倍。
(美聯社)