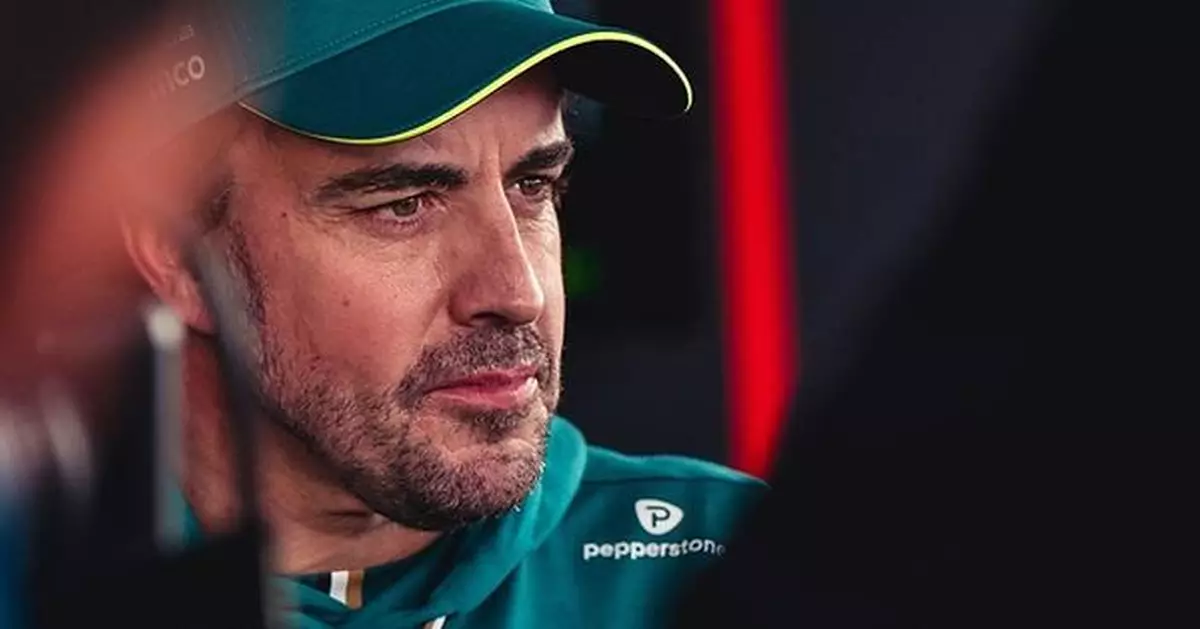
Pepperstone 深化與 Aston Martin Aramco Formula One™ 車隊的合作,進一步擴大品牌曝光,並宣布與兩屆 Formula One™ 世界冠軍費爾南多 • 阿隆索建立全新全球品牌大使合作關係,該合作將於 2027 年起生效。
澳洲墨爾本2026年10月29日 /美通社/ -- 全球線上交易服務供應商 Pepperstone 與 Aston Martin Aramco Formula One™ 車隊將延續並深化合作夥伴關係,兩屆 Formula One™ 世界冠軍費爾南多•阿隆索將於2027年起擔任 Pepperstone 全球品牌大使。
雙方將在本週末舉行的墨西哥城大獎賽上慶祝此次合作升級。屆時,費爾南多將佩戴特別設計的 Pepperstone 安全帽參賽,在 Formula One 最具活力的全球舞台之一,生動展現雙方的合作。
自2025年合作啟動以來,雙方始終秉持共同理念:更好的決策源於經驗、信任,以及對細節始終如一的關注。
無論是應對複雜的全球金融市場,還是在賽車運動的巔峰賽場上競技,成功都需要具備分析資訊、質疑既有假設,以及發現細微改進機會的能力。
費爾南多擁有逾二十年征戰頂級賽車賽事的經驗,充分展現了經驗、直覺與周密準備的價值。
他對卓越的不懈追求,以及始終全力以赴、絕不止步的態度,使他成為 Pepperstone 及其「Better Never Settles(追求卓越,永不止步)」理念的理想代言人。
「經驗讓我明白,最微小的細節也能帶來最大的不同。在整個職業生涯中,我學到的是,永遠不要停止尋找改進的方法,無論是了解賽車、分析數據,還是在壓力下做出決策。」Aston Martin Aramco Formula One 車隊車手兼 Pepperstone 全球品牌大使費爾南多•阿隆索表示。
「這就是為什麼我對雙方合作所秉持的『Better Never Settles(追求卓越,永不止步)』理念深有共鳴。這意味著相信自己的準備、運用自身經驗,並始終尋找下一步改進的機會。我很高興能成為 Pepperstone 全球品牌大使,並在本週末於墨西哥佩戴特別設計的安全帽,慶祝雙方的合作。」
此次合作升級之際,Pepperstone 正持續拓展全球業務,投資技術、豐富產品,並加強在核心市場及成長地區的布局。
「歡迎費爾南多•阿隆索擔任我們的全球品牌大使,這標誌著我們與 Aston Martin Aramco 的合作邁入令人振奮的新篇章。他不斷進取的動力,體現了 Pepperstone『Better Never Settles(追求卓越,永不止步)』的信念。」Pepperstone 集團執行長 Tamas Szabo 表示。
「我們正致力於拓展產品、提升技術,並擴大全球布局,打造全球最值得信賴的金融科技生態系統之一。與 Aston Martin Aramco 擴大的全球合作關係有助於實現這一目標,深化我們與全球受眾的聯繫,其中包括拉丁美洲這一 Pepperstone 的重要成長地區。」
關於 Pepperstone
Pepperstone 是一家全球金融科技公司及差價合約(CFD)經紀商,為160多個國家的交易者提供服務。公司透過業界領先的交易平台、具競爭力的定價及健全的監管框架,提供外匯、指數、大宗商品、股票、交易所交易基金(ETF)及數位資產市場的交易管道。
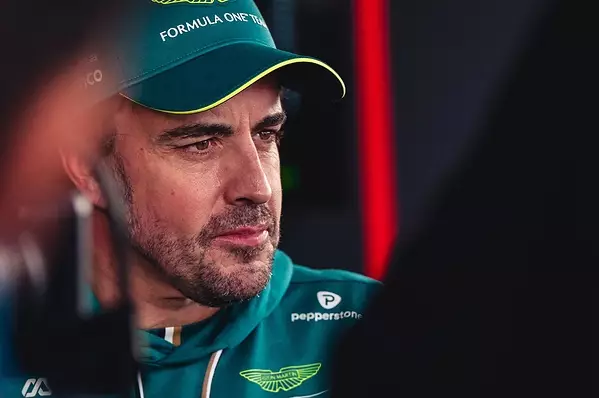
Pepperstone 與 Aston Martin Aramco 續約並擴大合作夥伴關係,費爾南多 • 阿隆索將於 2027 年起擔任全球品牌大使
** 本新聞稿由 PR Newswire 通過自動發布系统提供,內容由客戶承擔全部責任。**
一款在同量級模型中處於領先的通用模型,以遞歸自我改進構建,旨在推動 AI 與科學發現。
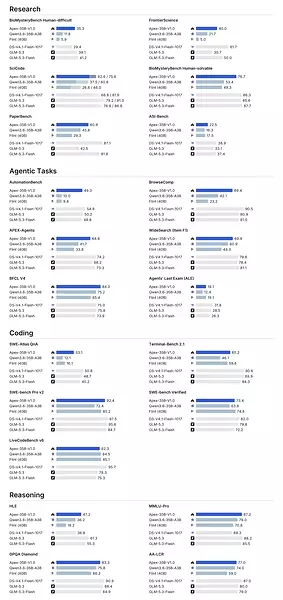
北京2026年10月29日 /美通社/ -- 超衍智能(Apex Intelligence)發佈了其首款模型 Apex-35B-V1.0。這款 35B 通用模型以 Qwen3.6-35B-A3B 為基礎,經過中訓練和後訓練進一步優化,模型開發過程中融入了大量自有數據集和研究軌跡。在參與評測的同量級模型中,Apex-35B-V1.0 的研發能力處於領先水平,同時保持了出色的通用能力;在部分基準測試中,其表現也可與更大尺寸規模的模型競爭。
模型構建過程中,AI 自主參與了數據構造、實驗設計、代碼執行、訓練結果分析和訓練優化等環節。在實際應用中,Apex-35B-V1.0 既能完成 Coding、Agent、問答和深度搜索等常規任務,也能完成計算閉環的研究任務,如 AI 研究、計算科學、機器人仿真等,是一款兼具通用能力與研究能力的模型。
Apex-35B-V1.0 既是遞歸自我改進的成果,也將成為繼續推動 AI 與科學研究的工具。
基準評測
在 21 項基準測試中,Apex-35B-V1.0 相比同量級的 Qwen3.6-35B-A3B 取得 20 項領先;相比 Recursive Flint(40B)取得 18 項領先、1 項持平。除了研究任務表現突出,它在智能體任務、編程和推理方面也展現出廣泛的競爭力,並在部分基準測試中超過更大規模的模型。這些結果表明,該模型在35B 規模下兼具突出的研究能力和廣泛的通用能力。更多詳情見技術博客。
Tech Blog:https://www.apexin.com/apex-35b/
通過遞歸自我改進構建
超衍智能(Apex Intelligence)的自進化 AI 研究系統 Apex Research能夠持續識別模型弱點、提出假設、開展實驗,並將研究發現轉化為可衡量的模型改進。
從自進化訓練數據和自動化實驗,到訓練方案、GPU 內核及推理優化,Apex Research 參與了 Apex-35B-V1.0 的整個開發過程。
自進化數據。 Apex Research 識別模型弱點,並自動生成有針對性的訓練數據。例如,當評測發現模型在計算流體力學(CFD)任務中出現失誤時,系統分析了背後的推理缺口,合成並驗證新的科學訓練樣例,再將其納入後續訓練。這套自進化數據流程使模型在內部 CFD-Bench 上的成績提高了 32.1 分。
自動化實驗。 Apex Research 分析評測結果和智能體運行軌跡,發現系統性的失敗模式,並優化訓練策略。例如,它發現過長的推理上下文和失衡的數據配比會降低智能體表現。隨後,系統探索了不同的序列長度分佈、長短軌跡採樣比例,以及考慮 token 數量的批次組成,找到更有效的訓練配置,提高了智能體的可靠性和訓練效率。
訓練與推理基礎設施。 Apex Research 將自動化優化擴展到底層計算系統,探索更高效的 GPU 內核、負載均衡、通信策略和執行調度。在訓練側,它優化 GPU 負載均衡、通信與計算重疊、動態批處理,以及考慮 token 數量的工作負載分配,以減少同步開銷、縮短 GPU 空閒時間、提高硬件利用率,使訓練吞吐量提升 45%–60%。在推理側,它優化注意力內核、KV 緩存管理,以及預填充和解碼階段的執行方式;在可比工作負載下,實現解碼速度提升至 1.6–1.8 倍,首 token 響應時間降低 30%–35%。
這些改進貫穿數據、訓練和基礎設施,並逐步累積為一個持續反饋的研究循環:每一輪研究的成果,都為下一輪改進提供基礎。
使用方式
Apex-35B-V1.0 的模型權重已在 Hugging Face 提供。配套代碼、部署指南和使用示例已在 GitHub 提供。開發者可以下載並運行該模型,將其用於 AI 開發、科學計算及其他研究任務。模型版本、硬件要求、支持的推理框架和許可信息詳見項目頁面。
GitHub:https://github.com/apexin-ai/Apex-35B-V1.0
Hugging Face:https://huggingface.co/Apexintelligence-AI/Apex-35B-V1.0
關於超衍智能(Apex Intelligence)
超衍智能由清華大學人工智能學院助理教授陳勇超創立,目標是構建下一代自進化基礎大模型。這裡的「自進化」指遞歸自我改進(Recursive Self-Improvement,RSI):讓 AI 參與研究、實驗與驗證,並將成果用於改進模型自身。
超衍智能希望推動 AI 從輔助工具成為共同研究者,從加速已知走向發現未知。公司的長期願景是讓模型具備相當於並逐步超過10 萬名覆蓋不同學科的頂尖 AI Scientist 的整體科研能力,持續參與科學研究與發現。
繼 Apex-35B-V1.0 模型之後,超衍智能計劃推出更大量級的自進化基礎大模型,新模型將繼續提升 AI 研發能力,並拓展至芯片、量子計算等科學研究領域。更多模型能力、評測結果與開放方式,敬請期待。
超衍智能發佈首個35B 模型 Apex-35B-V1.0,以遞歸自我改進推動 AI 與科學研究
** 本新聞稿由 PR Newswire 通過自動發布系统提供,內容由客戶承擔全部責任。**